
Antes de 1948 no existía una teoría general para medir la información producida por una fuente.
Claude Shannon convirtió una palabra común en una magnitud matemática.
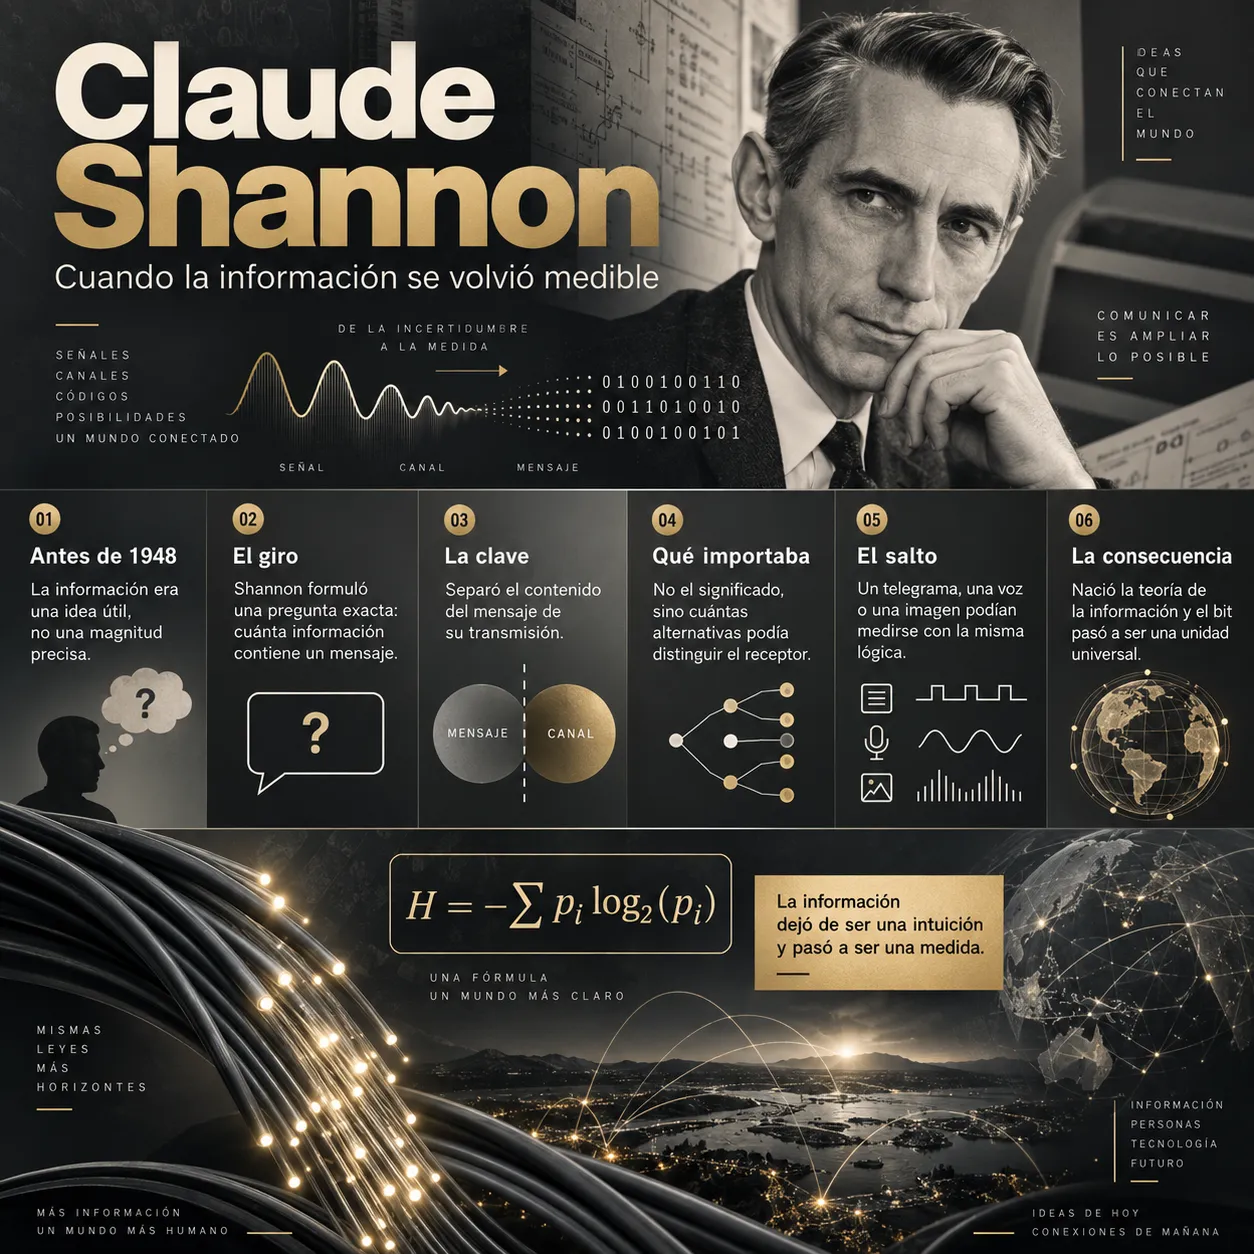
En 1948, el Bell System Technical Journal publicó en dos entregas un trabajo firmado por Claude Shannon, un ingeniero de treinta y dos años de los Laboratorios Bell. El artículo se titulaba «A Mathematical Theory of Communication» y planteaba una pregunta que hasta entonces no había recibido una formulación matemática general, cuánta información contiene realmente un mensaje, sin importar si ese mensaje es un telegrama, una fotografía, una señal telefónica o una frase hablada. Antes de Shannon, «información» era una palabra del lenguaje común. Después, pasó a ser una magnitud medible, comparable y transmisible bajo límites precisos.
Shannon no partía de cero. Trabajaba en una compañía telefónica que llevaba décadas intentando resolver un problema muy concreto, cuánta información puede viajar por un canal físico antes de que el ruido la vuelva inutilizable. Su aportación consistió en separar esa pregunta de ingeniería del contenido semántico del mensaje. Le daba igual si el texto transmitido tenía sentido, era verdadero o estaba formado por símbolos aleatorios. Lo que necesitaba medir era cuántas posibilidades distintas podía distinguir el receptor al otro lado de la línea.
Nyquist y Hartley habían medido restricciones del canal, no la incertidumbre del mensaje.
Dos ingenieros de Bell prepararon el terreno dos décadas antes.
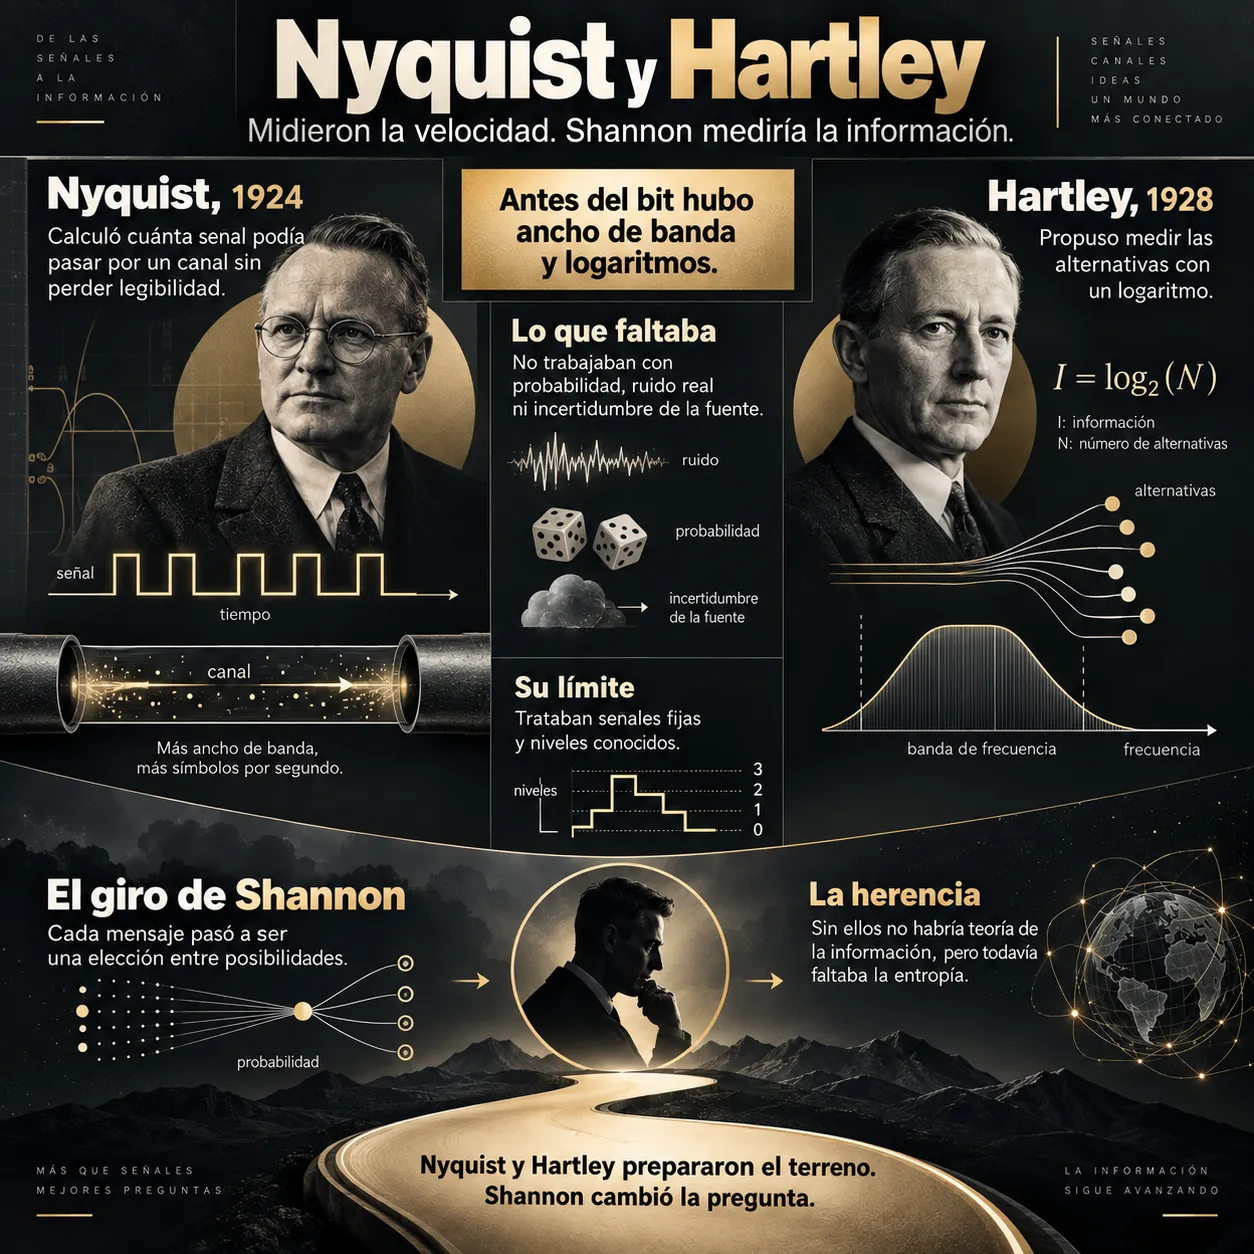
En 1924, Harry Nyquist publicó en la misma revista técnica un artículo titulado «Certain Factors Affecting Telegraph Speed». Su problema era práctico, cuántas señales distinguibles podía enviar un sistema telegráfico por unidad de tiempo sin perder legibilidad. Nyquist relacionó la velocidad máxima con el ancho de banda disponible y con el número de niveles de señal que el receptor podía separar de forma fiable.
Ralph Hartley avanzó un paso más en 1928 con «Transmission of Information». Propuso medir la cantidad de información mediante un logaritmo del número de alternativas posibles. Esa elección no era decorativa. Si dos sistemas independientes ofrecen varias posibilidades cada uno, el número total de combinaciones se multiplica, pero la cantidad de información debe sumarse. El logaritmo convierte esa multiplicación de posibilidades en una suma manejable.
Ni Nyquist ni Hartley definieron la información en términos probabilísticos. Sus modelos trabajaban con señales, niveles y alternativas contables, pero no con la incertidumbre real de una fuente que emite símbolos con frecuencias desiguales. Shannon tomó esa base y la reformuló, un mensaje no es solo una secuencia de señales, sino el resultado de una elección entre alternativas con probabilidades distintas.
La entropía convierte la incertidumbre de una fuente en un número.
Cuanto más predecible es una fuente, menos información produce cada símbolo.
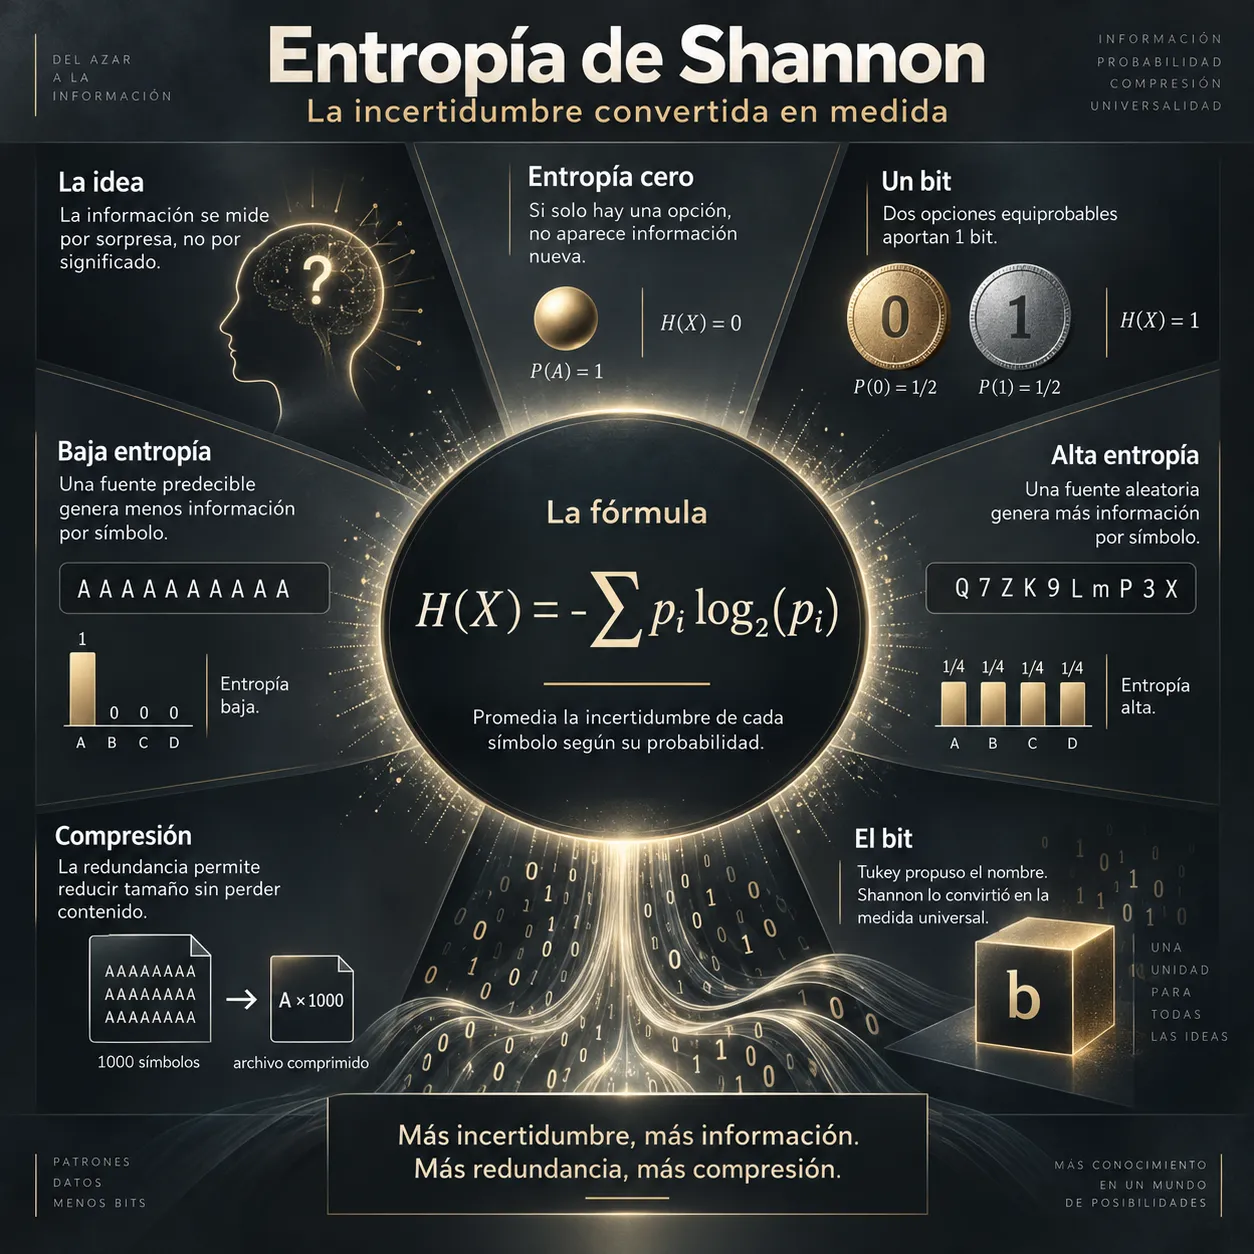
Shannon definió la entropía de una fuente de información como el promedio de incertidumbre que elimina cada símbolo emitido. Si algunos símbolos aparecen con mucha frecuencia y otros casi nunca, la fuente resulta parcialmente predecible. Si todos los símbolos son igualmente probables, cada emisión resuelve más incertidumbre.
La fórmula discreta habitual es esta:
\(H(X) = -\sum_{i=1}^{n} p_i \log_2(p_i)\)
En esa expresión, \(p_i\) representa la probabilidad del símbolo \(i\), y el logaritmo en base dos permite medir la información en bits. Si una fuente solo puede emitir un símbolo, ese símbolo no aporta información nueva, porque se conocía de antemano. Su entropía es cero. Si emite dos símbolos con la misma probabilidad, como una moneda ideal, cada lanzamiento aporta exactamente un bit.
El bit no fue una invención terminológica de Shannon. En su artículo reconoce que el término se lo sugirió John Tukey como abreviatura de «binary digit». Lo que sí hizo Shannon fue convertirlo en unidad general de medida de la información. Un idioma natural, donde letras y palabras aparecen con frecuencias y dependencias estadísticas desiguales, tiene una entropía por carácter menor que una secuencia equiprobable de símbolos independientes. Esa redundancia estadística es precisamente lo que permite comprimir texto sin perder información.
El teorema de codificación del canal fijó un límite que la ingeniería tardó décadas en rozar.
Shannon demostró la existencia de códigos eficaces, pero no entregó una receta práctica.
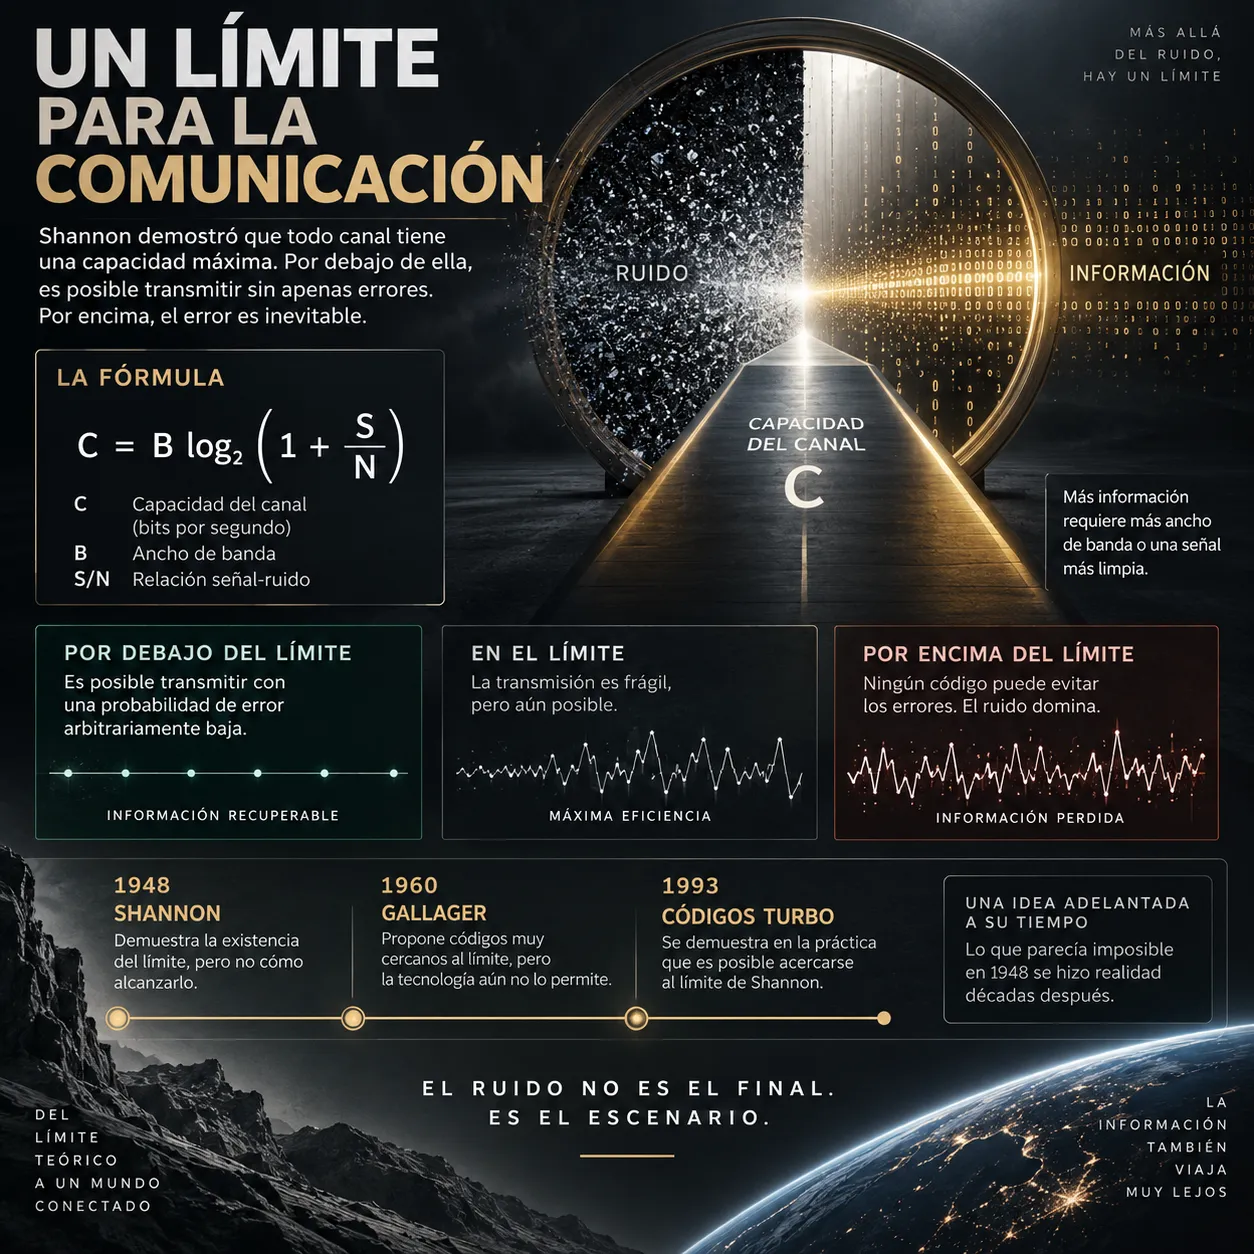
La segunda parte del trabajo de Shannon abordaba un problema más difícil, transmitir información a través de canales con ruido. Su resultado central afirma que todo modelo de canal tiene una capacidad máxima \(C\) bajo unas restricciones determinadas. Por debajo de esa capacidad, es posible transmitir con una probabilidad de error arbitrariamente baja utilizando códigos suficientemente largos y adecuados. A tasas superiores a esa capacidad, la probabilidad de error ya no puede hacerse arbitrariamente pequeña mediante codificación.
Para un canal con ruido gaussiano blanco aditivo, la expresión más citada de esa capacidad es:
\(C = B \log_2(1 + \frac{S}{N})\)
Aquí \(B\) es el ancho de banda del canal y \(S/N\) es la relación entre la potencia de la señal y la potencia del ruido. La ecuación no dice que el ruido desaparezca. Dice algo más preciso, si la tasa de transmisión se mantiene por debajo de \(C\), la probabilidad de error puede reducirse mediante codificación. Si se intenta superar esa capacidad, la codificación ya no puede hacer arbitrariamente pequeña esa probabilidad dentro de ese modelo de canal.
La demostración de Shannon no era constructiva. Probaba que debían existir códigos capaces de acercarse a la capacidad del canal, pero no explicaba cómo diseñarlos de forma eficiente. Robert Gallager propuso en su tesis doctoral de 1960 los códigos de verificación de paridad de baja densidad, conocidos como LDPC. Aquellos códigos se aproximaban notablemente al límite teórico, pero la decodificación exigía recursos que la tecnología de la época no podía asumir. Durante años quedaron más cerca de una posibilidad matemática que de un producto industrial.
La situación cambió en 1993 con los códigos turbo de Claude Berrou, Alain Glavieux y Punya Thitimajshima. Por primera vez se mostró en la práctica que era posible acercarse al límite de Shannon con esquemas de codificación utilizables. Ese resultado reactivó el interés por los códigos LDPC de Gallager y abrió una línea de ingeniería que hoy está en sistemas de almacenamiento, redes inalámbricas, comunicaciones ópticas y enlaces espaciales.
La teoría de Shannon sigue fijando los límites matemáticos de las comunicaciones actuales.
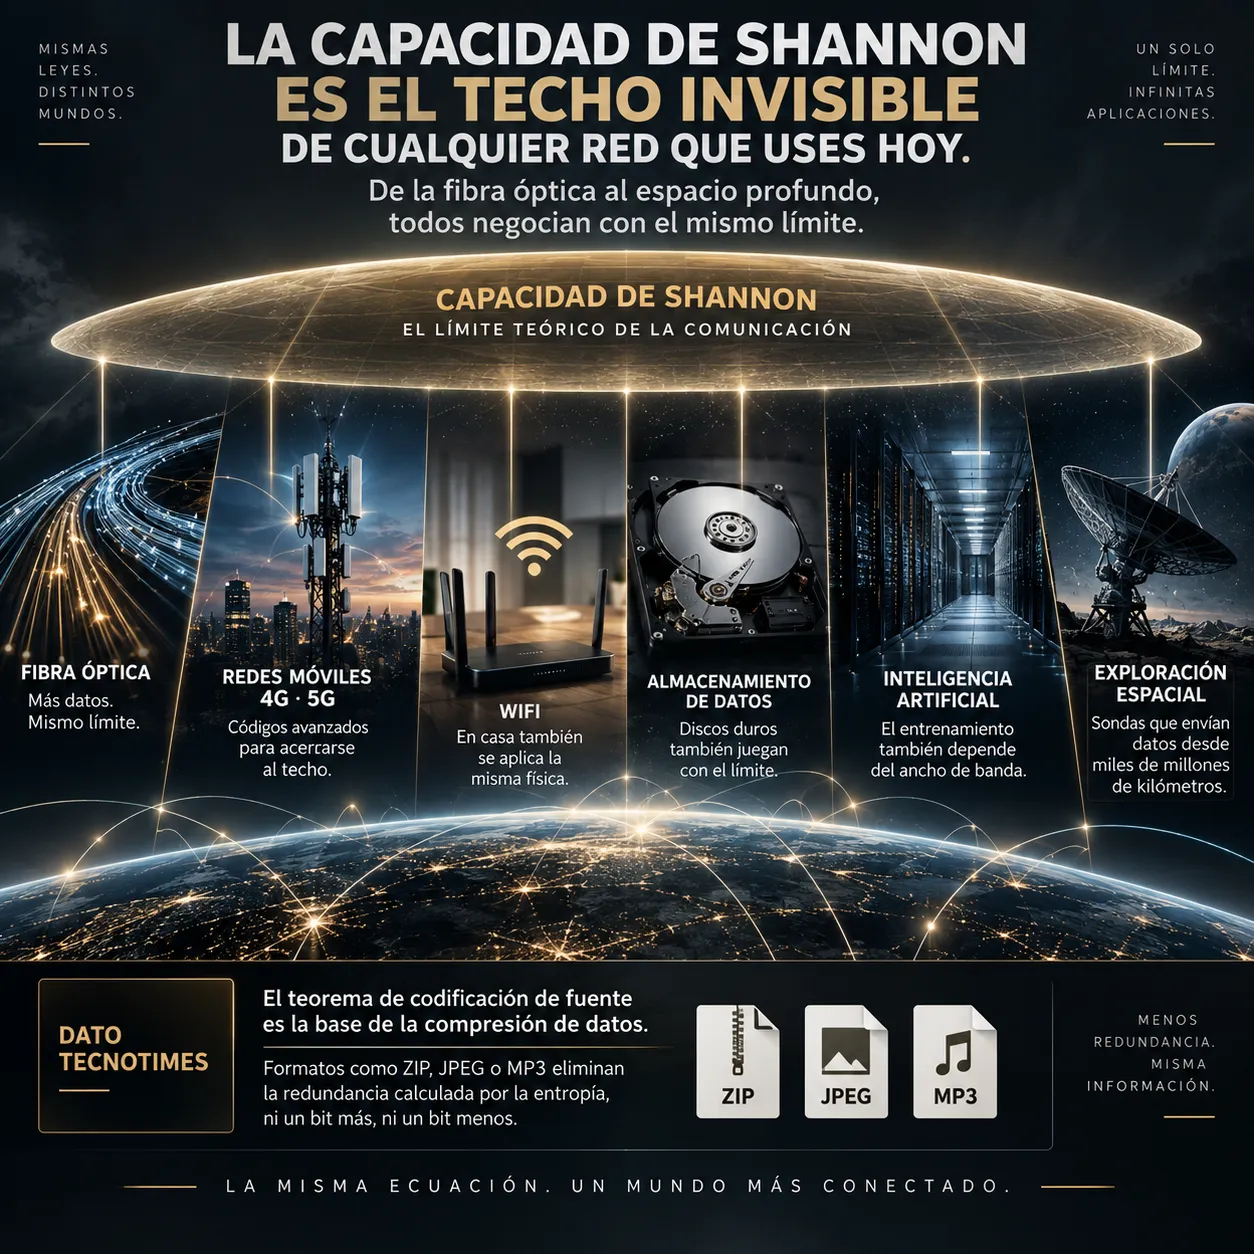
La fibra óptica, el wifi y el espacio profundo negocian con el mismo límite.
Los sistemas de comunicación actuales no se diseñan preguntando solo cuántos bits pueden enviarse, sino cuántos bits pueden enviarse con una tasa de error aceptable, una potencia determinada y un ancho de banda limitado. Ese cálculo sigue teniendo a Shannon como referencia. Los códigos LDPC aparecen en estándares como Wi-Fi, DVB-S2 y 5G para determinados canales de datos. Los códigos turbo fueron esenciales en generaciones anteriores de telefonía móvil y en comunicaciones espaciales. Los códigos polares, introducidos décadas después de Shannon, también forman parte de 5G en canales de control.
La capacidad de Shannon no es una cifra decorativa colocada al final de una especificación. Funciona como un límite contra el que se mide la eficiencia real de un sistema. Cuando una red inalámbrica, un enlace de fibra, un disco duro o una sonda espacial transmiten datos en presencia de ruido, interferencias o atenuación, la pregunta técnica es siempre parecida, cuánto se aproxima el sistema real al máximo que permite el canal.
Los centros de datos que entrenan modelos de inteligencia artificial afrontan otro tipo de límite de transferencia, mover datos entre memoria, procesadores, aceleradores y redes internas sin convertir el ancho de banda en el principal cuello de botella. No es el mismo problema de canal que estudió Shannon, pero comparte una restricción básica de ingeniería, el rendimiento depende de cuánta información puede desplazarse por unidad de tiempo bajo recursos finitos. TecnoTimes ya analizó esa limitación al tratar la memoria de alto ancho de banda, HBM.
Dato TecnoTimes. El teorema de codificación de fuente, la otra mitad del trabajo de Shannon, es la base conceptual de la compresión sin pérdida. En formatos y técnicas de compresión, la redundancia estadística no es un residuo molesto, sino el espacio exacto donde puede reducirse el tamaño de un mensaje sin alterar la información que contiene.
Shannon midió la información y dejó fuera el significado de forma deliberada.
La fuerza de su teoría procede precisamente de esa renuncia.
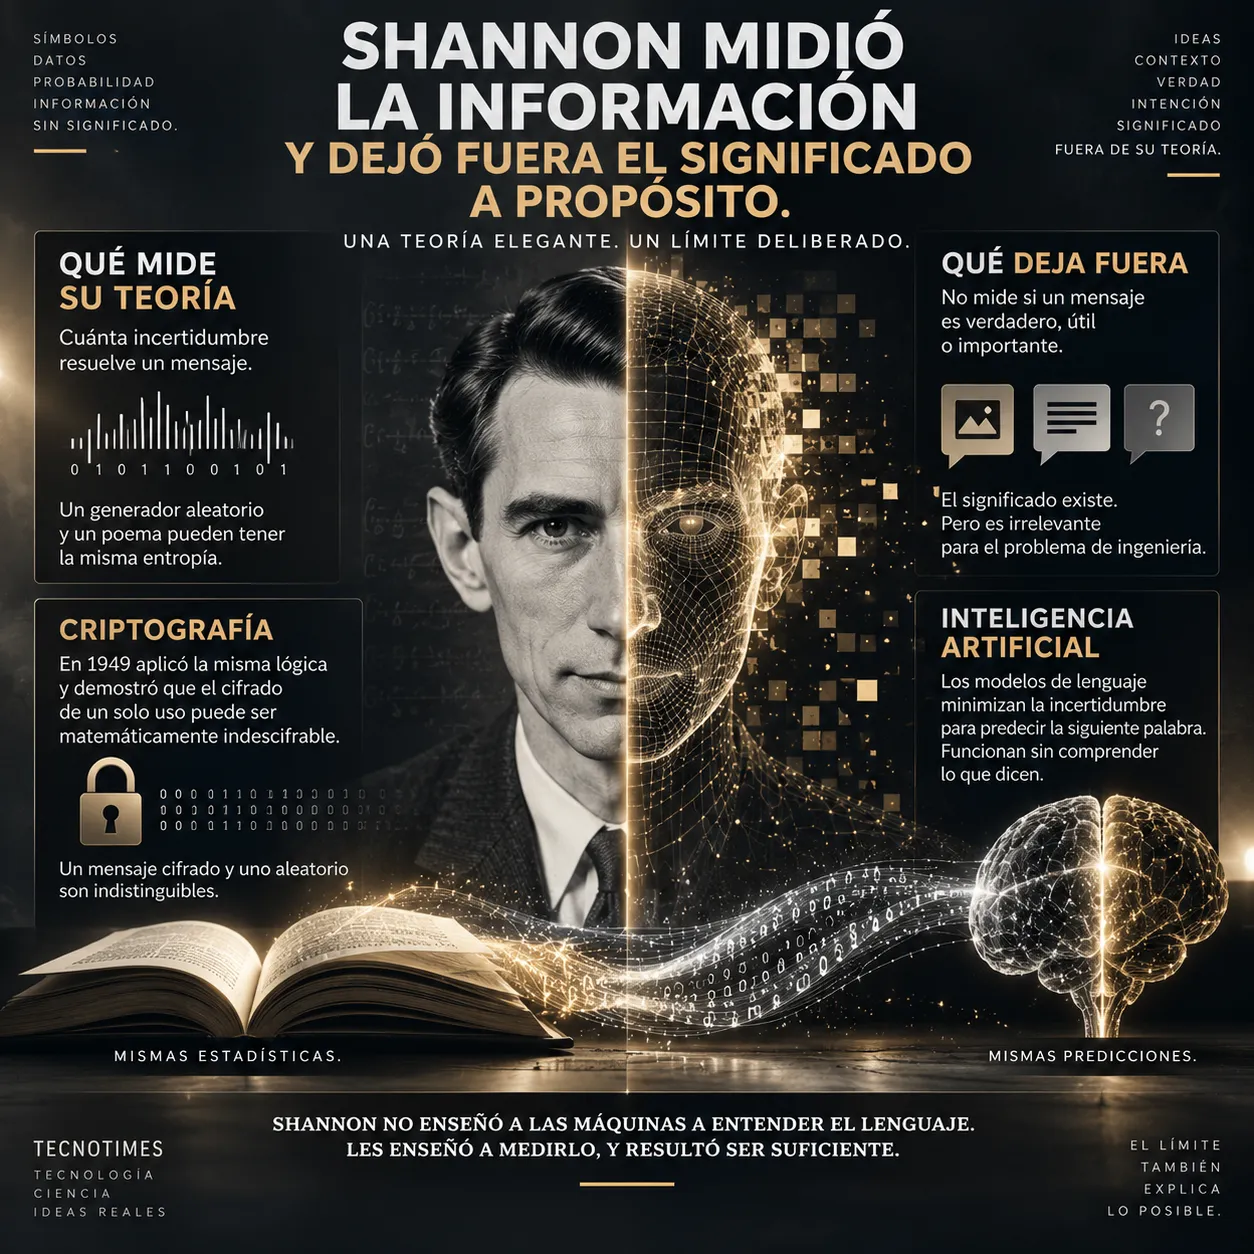
Shannon fue explícito desde el inicio de su artículo. Los mensajes pueden tener significado, referirse a entidades físicas o conceptuales y producir efectos en quien los recibe. Para el problema técnico de la comunicación, esos aspectos semánticos eran irrelevantes. Su teoría no mide si un mensaje es verdadero, útil, bello o absurdo. Mide cuánta incertidumbre resuelve dentro de un conjunto de posibilidades.
Esa separación explica por qué un generador aleatorio y un poema pueden tener entropías comparables por carácter, aunque uno no diga nada y el otro pueda sostener siglos de interpretación literaria. La teoría de Shannon no fracasa por ignorar esa diferencia. La ignora porque fue construida para resolver otro problema, transmitir símbolos de forma eficiente y fiable a través de un canal físico.
Un año después, en 1949, Shannon aplicó ese enfoque a la criptografía en «Communication Theory of Secrecy Systems». Allí formalizó las condiciones bajo las cuales un cifrado de un solo uso puede ofrecer secreto perfecto, la clave debe ser aleatoria, tan larga como el mensaje, utilizada una sola vez y desconocida para el adversario. Ese es el terreno matemático en el que TecnoTimes situó Kryptos y su cuarta sección todavía sin resolver. En un sistema con secreto perfecto, observar el criptograma no proporciona información sobre el mensaje original.
La lectura de TecnoTimes es que esa renuncia al significado sigue teniendo consecuencias directas en la inteligencia artificial actual. Entrenar un modelo de lenguaje autorregresivo consiste, en gran medida, en aprender una distribución de probabilidad sobre el siguiente token a partir de la secuencia previa. Esa operación puede producir sistemas capaces de generar texto coherente, traducir, resumir o programar, sin que de ahí se deduzca automáticamente comprensión en sentido humano. Shannon separó información y significado para poder medir la comunicación. Setenta y ocho años después, esa separación sigue marcando lo que estas máquinas hacen bien y lo que conviene no atribuirles por entusiasmo.
Referencias.
Fuentes y documentación utilizada.
Hartley, R. V. L. (1928). Transmission of Information. Bell System Technical Journal, 7(3), 535-563.
