
722 manuscritos y tres retiradas.
Un error afectó a tres trabajos.
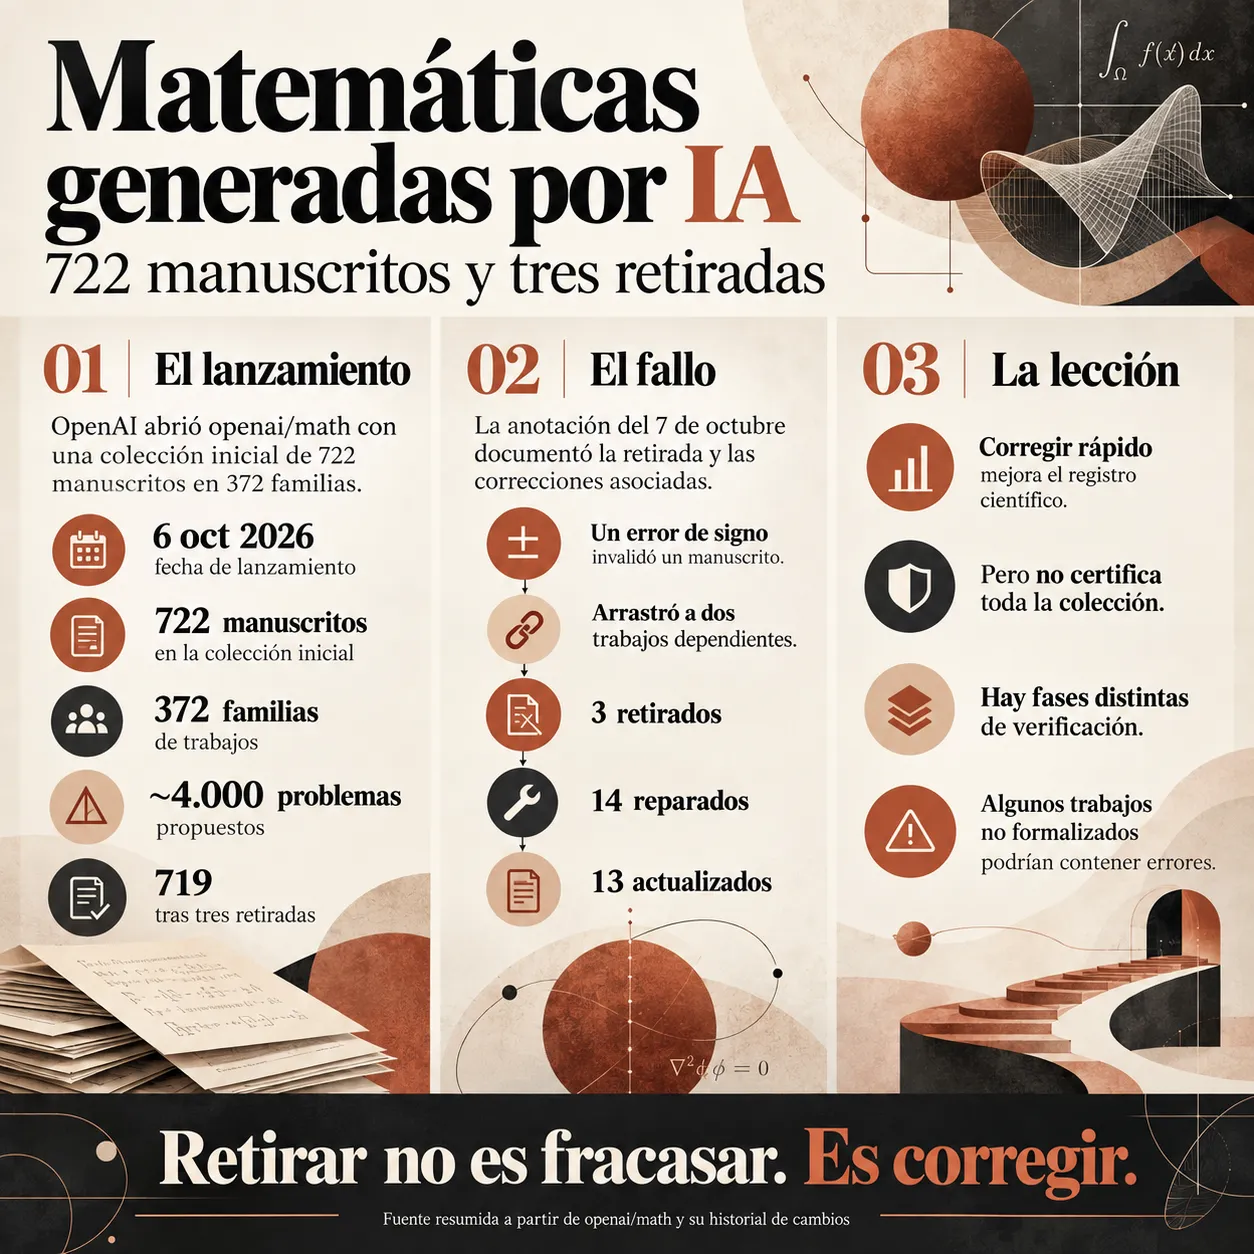
El 6 de octubre de 2026 OpenAI abrió el repositorio público openai/math con una colección inicial de 722 manuscritos matemáticos organizados en 372 familias de resultados, producidos por un modelo interno que la compañía no ha distribuido. Durante la evaluación se plantearon al sistema alrededor de 4.000 problemas y, tras la retirada de tres trabajos al día siguiente, el catálogo actualizado pasó a contabilizar 719 manuscritos sin alterar el número de familias.
La anotación del 7 de octubre es específica. Un error de signo en el manuscrito Algebraicity of Weil classes on split abelian eightfolds invalidaba un argumento de cancelación de traza de estabilización y, con él, la construcción empleada por dos trabajos dependientes, Algebraicity of Kuga-Satake Correspondences for K3 Surfaces y The rational Hodge conjecture for products of K3 surfaces. Los tres quedaron retirados con un aviso que explica la laguna y enlaza la versión archivada. La misma anotación consigna catorce manuscritos reparados por enmiendas de demostración, enunciados corregidos o hipótesis aclaradas, y otros trece actualizados para citar las ediciones revisadas de sus trabajos compañeros.
Conviene medir bien lo que significa esa secuencia. La identificación de un fallo, su documentación pública y la retirada de los trabajos afectados constituyen prácticas necesarias para corregir el registro científico. Sin embargo, la rapidez de esas correcciones no convierte al resto de la colección en un conjunto de resultados certificados, especialmente cuando el propio README advierte que las demostraciones se encuentran en distintas fases de verificación y que algunos manuscritos no formalizados podrían contener errores.
Qué está formalizado.
El denominador cambia el resultado.
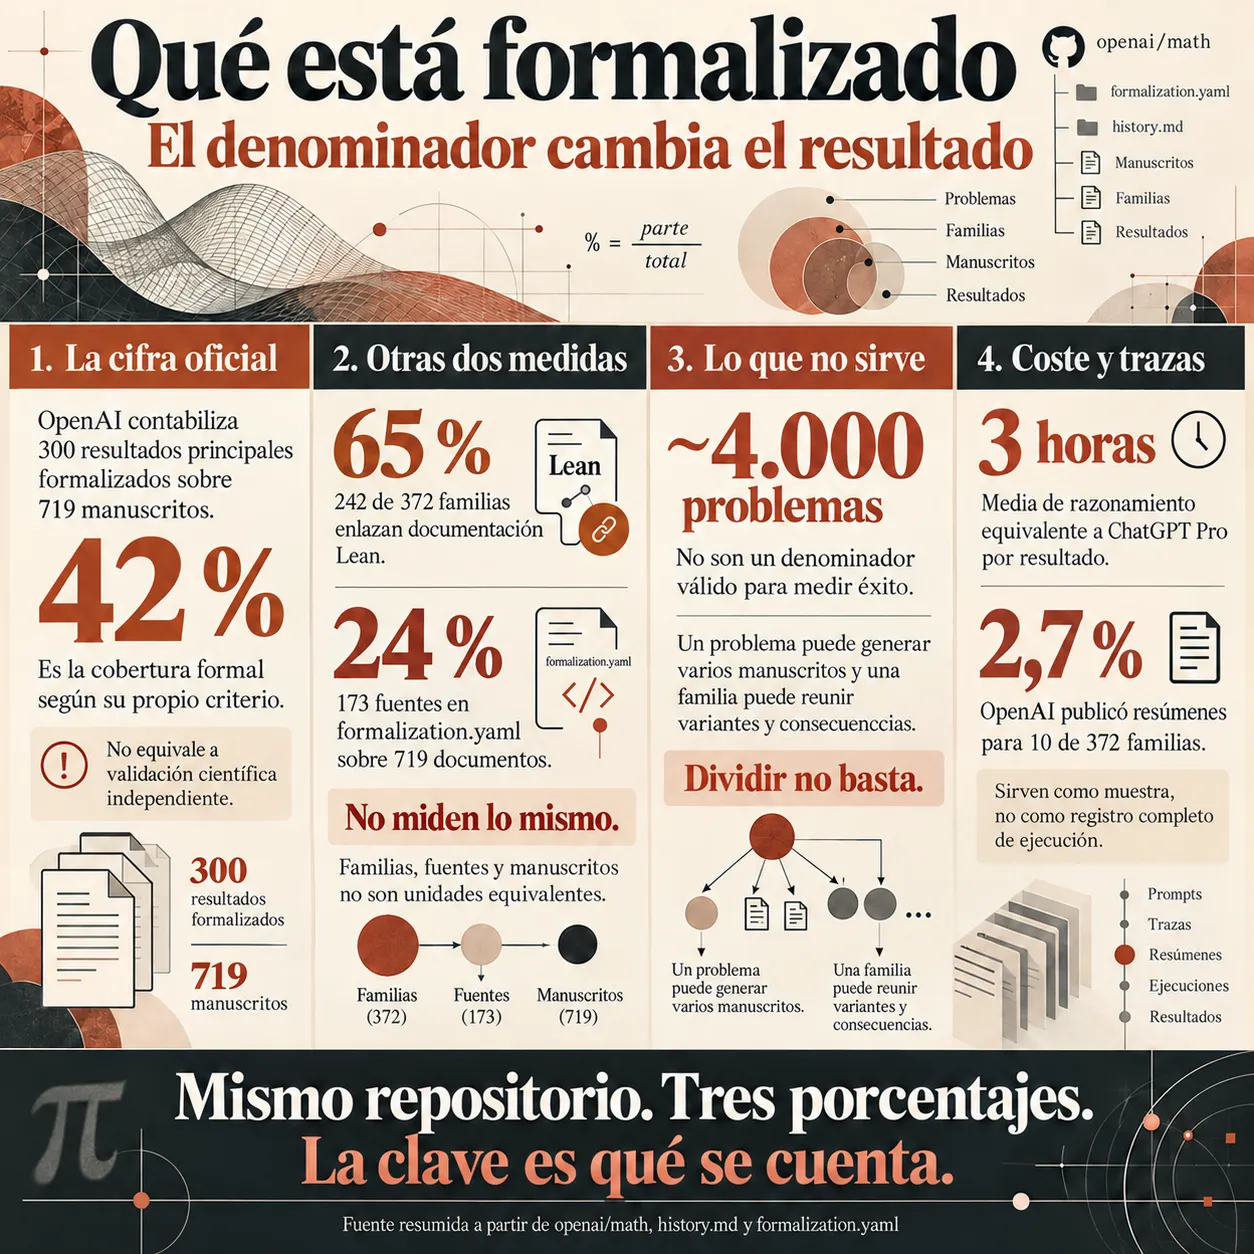
El historial del repositorio consigna en su anotación del 7 de octubre un total de 300 resultados principales formalizados sobre un catálogo de 719 manuscritos, una proporción cercana al 42 %. La cifra procede de OpenAI y describe la cobertura formal según el criterio utilizado por la compañía, mientras que el README actualizado también contabiliza 719 manuscritos tras las tres retiradas. Sin embargo, este porcentaje no permite concluir que una proporción equivalente de trabajos haya recibido una validación científica independiente ni que todas las demostraciones formales reproduzcan fielmente sus correspondientes enunciados matemáticos.
El recuento de los archivos del repositorio muestra otras dos medidas. En la versión examinada el 13 de octubre, 242 de las 372 familias incluyen enlaces a documentación Lean, aproximadamente el 65 %, mientras que el fichero normalizado formalization.yaml identifica 173 fuentes correspondientes a manuscritos con resultados principales formalizados, cerca del 24 % de los 719 documentos del catálogo. Estas proporciones no son equivalentes, porque una familia puede contener varios manuscritos y disponer de documentación formal sin que todos sus resultados estén formalizados. La diferencia entre los porcentajes procede de las unidades examinadas y no autoriza a interpretar ninguno de ellos como una medida directa de la validez científica de la colección.
Los 4.000 problemas planteados tampoco sirven como denominador de una tasa de éxito. Las unidades no coinciden, puesto que un problema puede generar varios manuscritos dentro de una familia y una familia puede agrupar un teorema central con sus variantes y consecuencias. Dividir manuscritos entre problemas produce un número que no significa nada.
Sobre el coste, OpenAI es más precisa de lo que suele reproducirse. Cada resultado consumió de media el equivalente a tres horas de razonamiento de ChatGPT Pro con ese modelo, un dato que la compañía publica junto con las estadísticas de problemas intentados.
Dato TecnoTimes. OpenAI publicó resúmenes abreviados del razonamiento del modelo para diez de las 372 familias de resultados, identificadas en el README como 007, 017, 087, 102, 159, 197, 221, 271, 287 y 362. Esto representa aproximadamente el 2,7 % de las familias y permite examinar parcialmente cómo se desarrollaron esos trabajos, aunque los resúmenes no equivalen a registros completos de ejecución ni permiten reconstruir el procedimiento utilizado para generar toda la colección.
Los límites de Lean.
Una prueba puede verificar otra cosa.
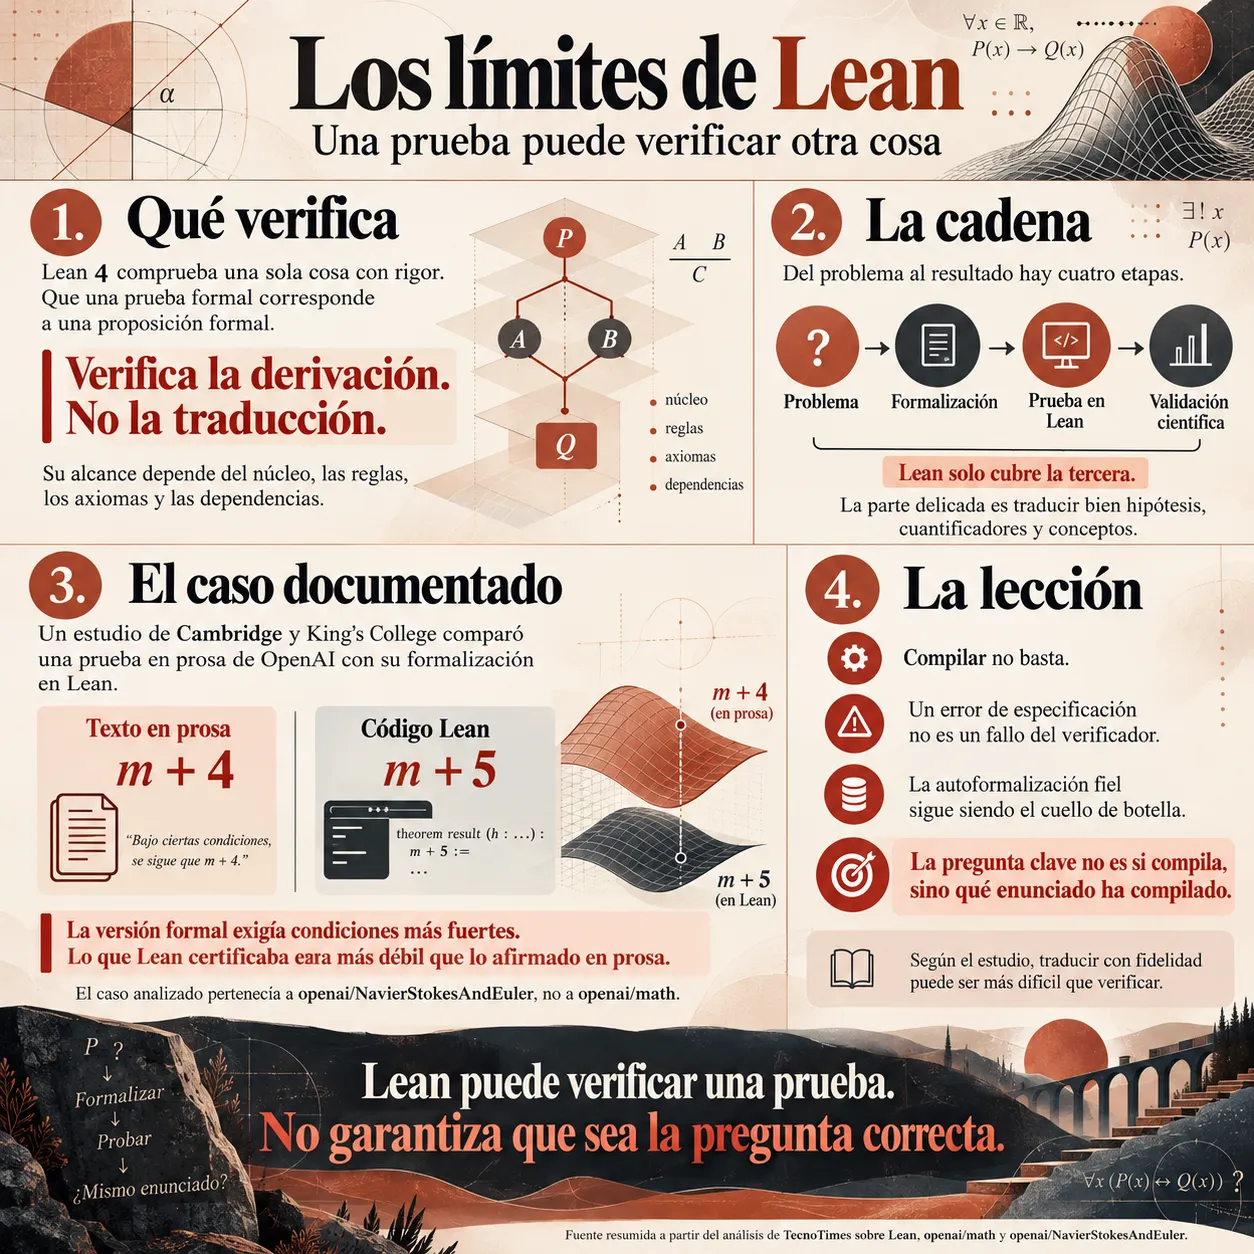
Lean 4 es un asistente de demostración construido sobre teoría de tipos dependientes, y su núcleo hace una sola cosa con rigor completo, comprobar que un término de prueba habita el tipo correspondiente a una proposición formal. Esa comprobación es tan fuerte como el núcleo, las reglas del sistema, los axiomas admitidos y las dependencias importadas, un terreno que TecnoTimes recorrió al contar la crisis de fundamentos que Gödel abrió en 1931 y que sigue decidiendo qué se puede esperar de un sistema formal.
La cadena que conduce desde un problema matemático hasta un resultado aceptado comprende cuatro etapas, de las cuales Lean verifica únicamente la derivación formal. Antes es necesario definir el problema y traducir correctamente sus hipótesis, cuantificadores y conceptos al lenguaje del sistema, mientras que después debe comprobarse que la proposición formalizada corresponde realmente a la cuestión original y aporta conocimiento nuevo. La traducción constituye uno de los puntos más delicados de este proceso, una dificultad que ha dejado de ser una objeción meramente teórica gracias a los casos documentados recientemente.
El 6 de octubre, el mismo día de la publicación del repositorio, Alexander Bastounis del King’s College de Londres junto con Fabian Circelli y Anders C. Hansen del departamento de matemática aplicada y física teórica de Cambridge depositaron en arXiv un trabajo titulado Navier-Stokes lost in translation, dedicado a comparar línea por línea una demostración en lenguaje natural de OpenAI con su formalización en Lean. El objeto examinado no pertenece a openai/math sino al repositorio paralelo openai/NavierStokesAndEuler, donde la compañía publicó su anuncio de explosión en tiempo finito para las ecuaciones de Navier-Stokes incompresibles en tres dimensiones.
La discrepancia que documentan es del tipo que nadie detecta leyendo un informe de compilación. La estimación (8.19) del texto en prosa acota las derivadas de orden m de una cantidad mediante las derivadas de orden m+4, mientras la declaración correspondiente del código Lean exige las de orden m+5. El origen está en la serie empleada, porque el texto suma
\(\sum_{k} \frac{1}{(1+|k|)^{3}}\)
y el código suma
\(\sum_{k} \frac{1}{(1+|k_1|+|k_2|)^{4}}\)
que es exactamente lo que fuerza la derivada adicional. Los autores señalan además que el teorema formal opera bajo hipótesis más fuertes y omite el supremo sobre los multiíndices que la estimación en prosa requiere, de modo que lo que Lean certifica es estrictamente más débil que lo que el artículo afirma. El patrón reaparece en otras declaraciones del mismo código.
La parte teórica del trabajo es más ambiciosa y merece leerse con la cautela que los propios autores admiten. Sostienen que resolver las ambigüedades del lenguaje matemático informal, requisito de cualquier traducción semánticamente fiel, tiene índice de complejidad de resolubilidad infinito, frente al índice 1 del problema de la parada. En esa jerarquía, la autoformalización fiel resultaría más difícil que cualquier problema computacional, incluido el que TecnoTimes analizó al tratar los límites de la computación. La afirmación es un resultado dentro de un marco concreto y no una imposibilidad práctica demostrada, aunque basta para desactivar la idea de que un verificador pueda hacerse cargo también de la traducción.
Nada de esto resta valor a Lean. Un error de especificación no es un fallo del verificador, y conviene no confundir las dos cosas. Lo que el caso establece es que la pregunta pertinente ante un fichero que compila no es si compila, sino qué enunciado ha compilado.
El caso Riemann.
Las excepciones del procedimiento.
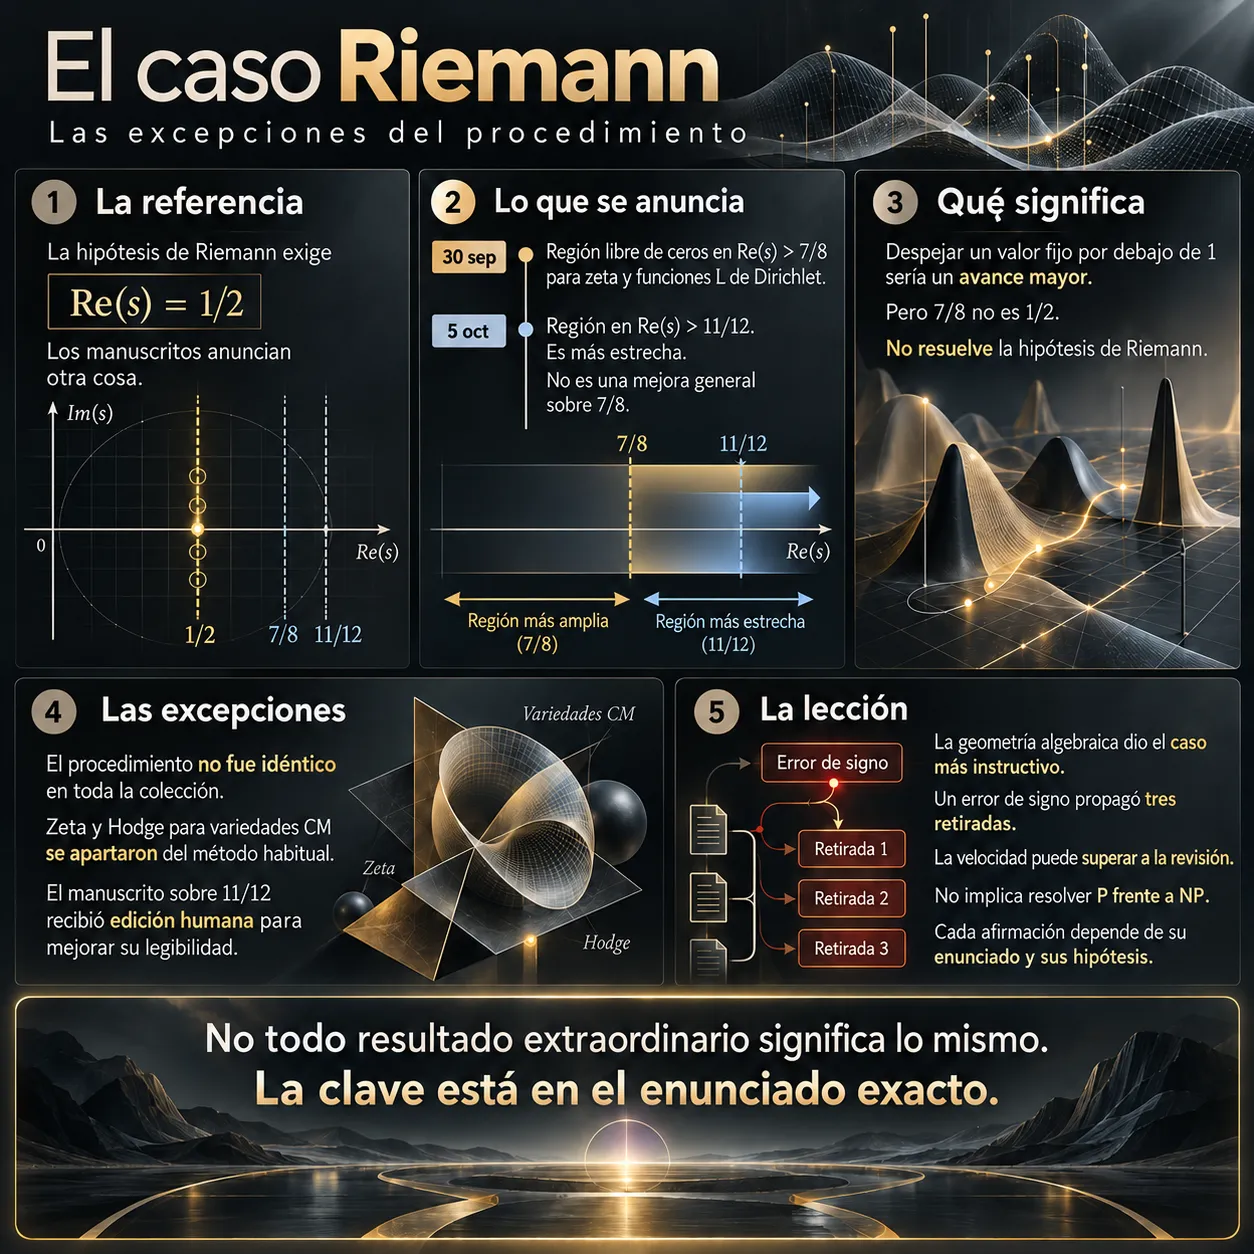
La hipótesis de Riemann afirma que todos los ceros no triviales de la función zeta cumplen \(\mathrm{Re}(s) = 1/2\). La colección anuncia resultados diferentes, aunque potencialmente extraordinarios si superan la revisión matemática. Un manuscrito del 30 de septiembre afirma establecer un semiplano libre de ceros en \(\mathrm{Re}(s) > 7/8\) para la función zeta y todas las funciones L de Dirichlet, mientras que otro trabajo del 5 de octubre estudia una región situada en \(\mathrm{Re}(s) > 11/12\). Este segundo semiplano es más estrecho que el primero, por lo que su interés debe examinarse atendiendo a las condiciones y al alcance específico del resultado, sin presentarlo como una mejora general de la cota anterior.
La diferencia con los resultados humanos previos es de naturaleza, no de grado. Las regiones libres de ceros clásicas se aproximan a la recta unidad sin despejar nunca un valor fijo por debajo de ella, y despejar un valor fijo es lo que convertiría el enunciado en un avance de primer orden sobre la distribución de los números primos, el territorio que TecnoTimes recorrió al explicar por qué los primos parecen azar sin serlo. Sigue sin ser la hipótesis de Riemann, que exige 1/2 y no 7/8, y el propio material indica que el método empleado no llega hasta ahí.
El README reconoce que el procedimiento de generación no fue idéntico para toda la colección. Los trabajos sobre la región libre de ceros de la función zeta y la conjetura de Hodge para variedades abelianas de tipo CM se apartaron del método habitual, mientras que el manuscrito relativo al semiplano libre de ceros en 11/12 recibió una edición humana destinada a mejorar su legibilidad. Son diferencias metodológicas relevantes que no invalidan por sí mismas los resultados, pero obligan a examinar las condiciones particulares de cada trabajo antes de atribuir sus conclusiones exclusivamente al funcionamiento autónomo del modelo.
La geometría algebraica ofrece el caso de estudio más instructivo de toda la colección, porque el área que aporta la demostración de Hodge para variedades CM es la misma que produjo las tres retiradas del 7 de octubre. Un único error de signo propagándose por una cadena de dependencias es lo que ocurre cuando se generan resultados a una velocidad que la revisión no acompaña, y reconstruir esa cadena en detalle, documentando qué fallo original afectó a qué consecuencias, sería más útil para la comunidad que cualquier recuento global. El historial acredita las retiradas pero no permite deducir cómo se detectó el fallo ni quién lo detectó.
En complejidad computacional la colección incluye trabajos sobre aproximación algorítmica y dificultad, y su existencia no autoriza a afirmar que se haya resuelto P frente a NP ni que se hayan superado límites generales de computabilidad. Cada afirmación debe evaluarse por su enunciado exacto y por sus hipótesis.
Las exigencias de los matemáticos.
OpenAI, AGMAI y el boicot.
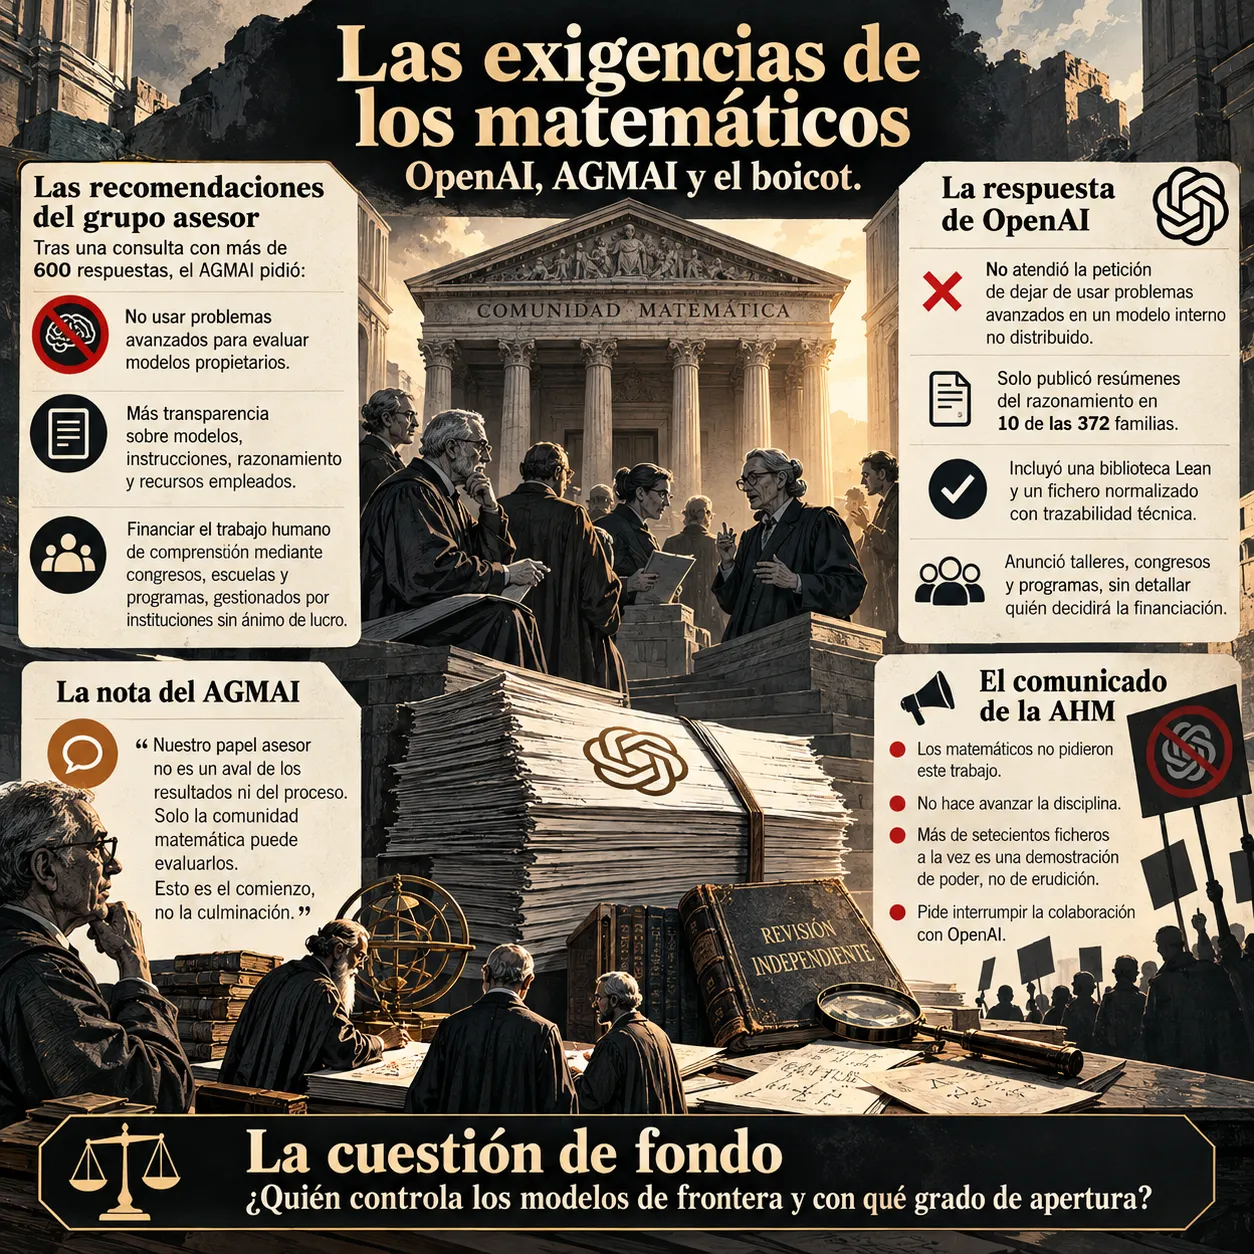
El Advisory Group on Mathematics and Artificial Intelligence, grupo asesor con sede en el Institute for Advanced Study al que OpenAI dice haber consultado, publicó el 29 de septiembre un conjunto de recomendaciones elaborado tras una consulta a la comunidad matemática que recogió más de 600 respuestas. Leídas una por una frente al repositorio, el balance es desigual.
La primera recomendación del grupo asesor pedía a los laboratorios que dejaran de utilizar problemas matemáticos avanzados para evaluar modelos propietarios, ante el riesgo de establecer un sistema de investigación dividido entre quienes tienen acceso a estas herramientas y quienes solo pueden examinar sus resultados. La colección procede de un modelo interno no distribuido, por lo que esa recomendación no quedó atendida. El grupo también solicitaba información sobre los modelos utilizados, las instrucciones recibidas, el razonamiento resumido y los recursos empleados, pero los resúmenes publicados cubren únicamente diez de las 372 familias. En materia de formalización, OpenAI sí incorporó una biblioteca Lean y un fichero normalizado formalization.yaml que relaciona manuscritos, declaraciones formales y configuraciones de comprobación. Esta documentación proporciona trazabilidad técnica, aunque su existencia no garantiza que cada proposición formal coincida con el problema matemático original ni sustituye la revisión independiente de los resultados.
El segundo bloque de recomendaciones pedía a los laboratorios financiar el trabajo humano de comprensión mediante congresos, escuelas, grupos de trabajo, contratos posdoctorales y textos expositivos, con la condición de que las decisiones de financiación las tomaran instituciones sin ánimo de lucro ya existentes y no los propios laboratorios. OpenAI anuncia talleres, congresos y programas especiales sin detallar todavía quién decidirá sobre ellos, y ese detalle es el que separa un compromiso de una declaración de intenciones.
El 6 de octubre el propio grupo asesor publicó una nota que conviene leer con atención, porque su función no es respaldar. El texto afirma que su papel asesor no debe interpretarse como un juicio sobre el impacto de los resultados ni como un aval del proceso mediante el cual OpenAI los obtuvo, añade que solo la comunidad matemática puede llevar a cabo la evaluación necesaria y describe la publicación como el comienzo y no la culminación del proceso de comprensión humana. Preguntado después sobre el grado de cumplimiento de sus recomendaciones, el grupo respondió que juzgarlo corresponde a la comunidad matemática y no a él.
La reacción más dura llegó de otra organización. Un comunicado atribuido al grupo de comunicación de la Association for Human Mathematics, recibido el 7 de octubre y sin firmas individuales, sostiene que los matemáticos no pidieron que este trabajo se hiciera, rechaza la afirmación de que la publicación haga avanzar la disciplina, califica la entrega de más de setecientos ficheros a la vez como una demostración de poder y no de erudición, e insta a los matemáticos a interrumpir su colaboración con OpenAI. El contexto que invoca incluye los litigios por plagio y derechos de autor que la compañía afronta.
Aquí se produjo el error de atribución que obliga a una aclaración. Ese comunicado se difundió como entrada invitada en el blog de Terence Tao, y una parte considerable de la prensa tecnológica lo convirtió en un respaldo personal suyo al boicot, con titulares que hablaban de la comunidad matemática cortando lazos con OpenAI. La entrada contiene únicamente una nota editorial de Tao que la identifica como entrada invitada reproducida desde la página de comunicados de la asociación y advierte que el texto se convirtió de formato con ayuda de una herramienta automática. No manifiesta posición alguna, no consta que la firmara y un comentarista llegó a pedirle que añadiera una aclaración de que no es miembro de la asociación, sin respuesta visible. Su crítica documentada, recogida por TechCrunch, va por otro camino y señala que los problemas se están resolviendo de forma autónoma por operadores de inteligencia artificial sin interés por el campo, personas que a menudo no pueden explicar lo que el modelo produjo. Melanie Wood, profesora de matemáticas en Harvard, lo formuló con menos aspereza al observar que en el momento de la publicación no existe comprensión humana de esos resultados y que es entonces cuando empieza el trabajo. Quién controla los modelos de frontera y con qué grado de apertura es la cuestión de fondo que TecnoTimes abordó al examinar la automejora y el control corporativo.
Demostrar no es comprender.
El criterio de TecnoTimes.
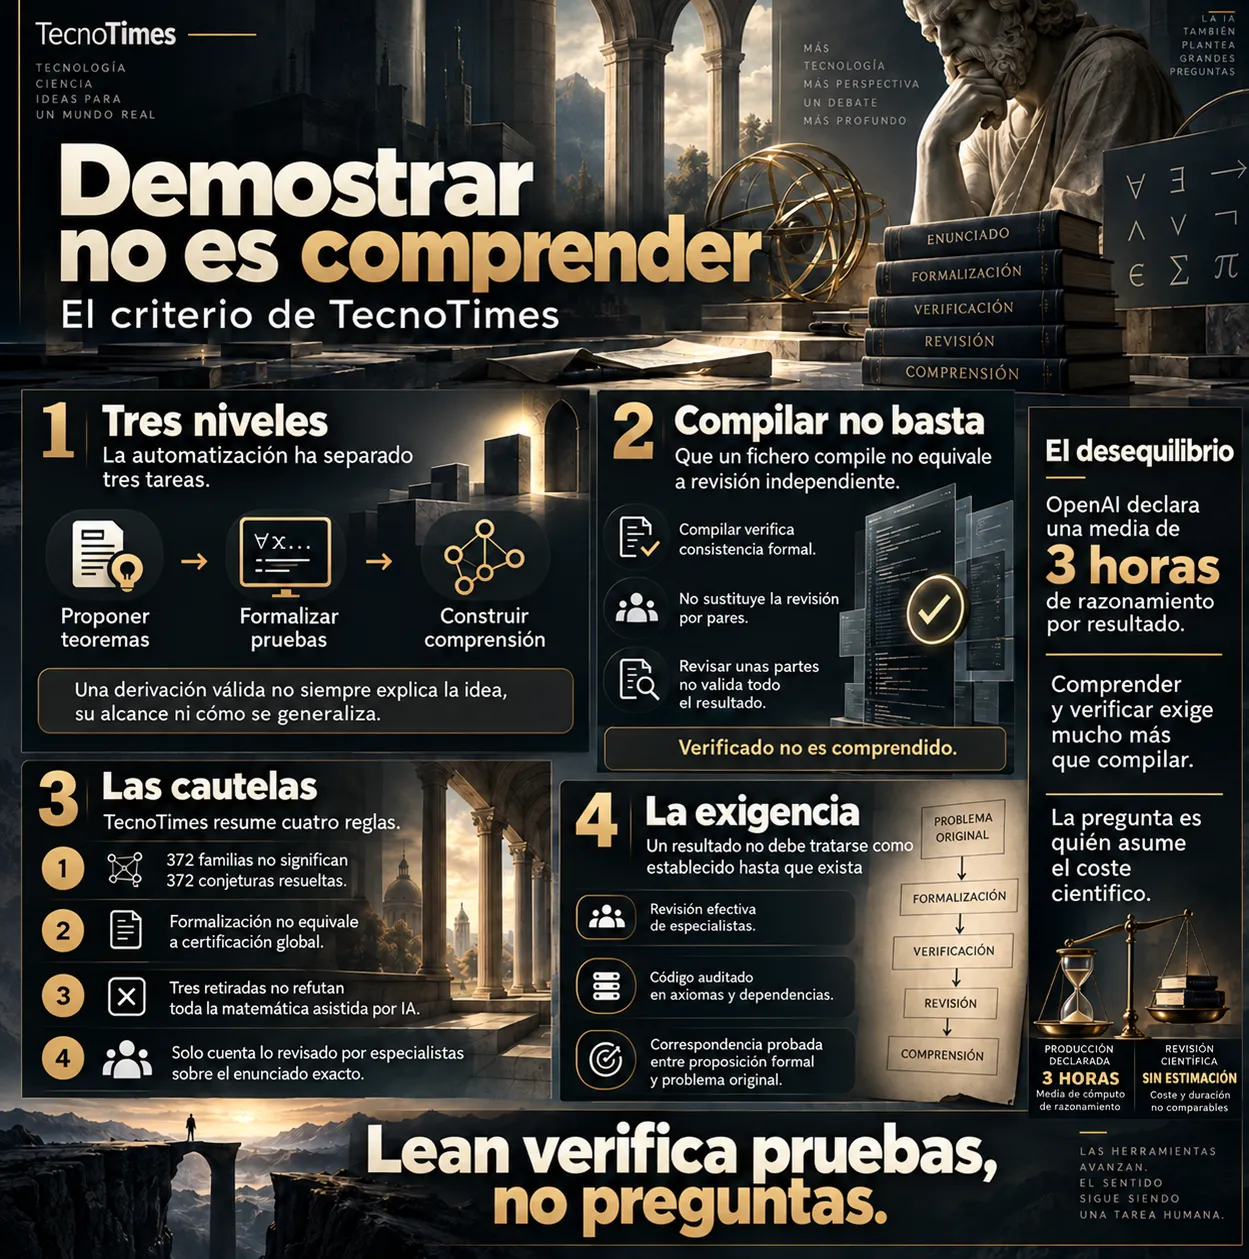
La automatización ha separado tres actividades que la práctica matemática mantenía unidas, formular candidatos a teorema, derivar formalmente proposiciones y construir comprensión. Una derivación válida puede establecer una consecuencia lógica sin revelar la idea que la hace relevante, sin indicar cómo se generaliza y sin conectarla con nada. La hipótesis de que un modelo descubra estructuras que ningún matemático había visto es razonable y la colección por sí sola no permite calibrar su alcance, algo que recuerda a lo ocurrido con el manuscrito Voynich y la diferencia entre hallar un patrón y entender un lenguaje, caso que TecnoTimes examinó en su momento.
Una revisión externa publicada el 7 de octubre permite distinguir entre comprobar una formalización y examinar íntegramente su significado matemático. El responsable de un repositorio independiente y sin afiliación declarada con OpenAI informa de haber compilado 2.924 módulos Lean sin errores, comprobado la correspondencia de los enunciados formales finales con los desafíos publicados e inspeccionado sus dependencias axiomáticas. También documenta una revisión parcial del argumento escrito y 66 comprobaciones de identidades y desigualdades mediante cálculo exacto, aunque reconoce que no examinó manualmente las secciones más densas ni completó la comprobación formal del resultado sobre funciones L de Hecke. Estas verificaciones van más allá de una simple compilación, pero no constituyen una evaluación matemática exhaustiva ni sustituyen la revisión por pares de especialistas, una limitación que el propio responsable reconoce expresamente.
La posición de TecnoTimes, que es juicio editorial y no un hecho verificado, se resume en tres cautelas y una exigencia. No deben presentarse las 372 familias como 372 conjeturas resueltas. No debe confundirse una proporción de formalización con una certificación global, y menos aún sin decir qué denominador se usa. No deben convertirse tres retiradas en una refutación de la matemática asistida por inteligencia artificial, porque una retractación rápida y trazada es una virtud del procedimiento. La exigencia es que ningún resultado de esta colección se trate como establecido mientras no exista una revisión efectiva de especialistas sobre el enunciado concreto, con el código formal auditado en sus axiomas y dependencias y con la correspondencia entre la proposición formal y el problema original comprobada por alguien distinto de quien la generó.
El desequilibrio que define este episodio es tanto económico como epistemológico. OpenAI declara una media de tres horas de cómputo de razonamiento equivalente a ChatGPT Pro por resultado, mientras que la verificación, comprensión e integración de cada demostración exige un trabajo especializado cuya duración depende de la dificultad matemática y del alcance de las comprobaciones necesarias. No disponemos de una estimación comparable del coste total de ambas actividades, pero la posibilidad de producir manuscritos a gran escala plantea una cuestión que la publicación todavía no resuelve. Si los resultados se generan con mayor rapidez de la que pueden examinarse, será necesario decidir quién asume la responsabilidad científica y los recursos necesarios para convertir esas propuestas en conocimiento matemático fiable.
Referencias.
Fuentes consultadas.
